Domain western-deko.de kaufen?
Wir ziehen mit dem Projekt
western-deko.de um.
Sind Sie am Kauf der Domain
western-deko.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain western-deko.de kaufen?
Kennt ihr ein gutes Open-Source-Text-to-Speech (TTS)-Modell?
Ja, ein bekanntes Open-Source-Text-to-Speech-Modell ist Tacotron. Es wurde von Google entwickelt und ist in der Lage, natürliche Sprache zu generieren. Tacotron ist in Python implementiert und kann für verschiedene Anwendungen verwendet werden, wie z.B. Sprachassistenten oder Hörbücher. **
Wie funktioniert Speech to Text?
Speech to Text funktioniert, indem gesprochene Wörter mithilfe von Spracherkennungssoftware in Text umgewandelt werden. Dabei werden die Audiosignale des gesprochenen Textes analysiert und in Text umgewandelt. Die Software erkennt dabei Sprachmuster, Wörter und Sätze, um sie korrekt zu transkribieren. Dieser Prozess basiert auf komplexen Algorithmen und künstlicher Intelligenz, die kontinuierlich verbessert werden, um die Genauigkeit der Umwandlung zu erhöhen. Das Ergebnis ist ein geschriebener Text, der die gesprochene Sprache möglichst genau wiedergibt. **
Ähnliche Suchbegriffe für Text-to-Speech TTS
Top-Angebote
Produkte zum Begriff Text-to-Speech TTS:
-
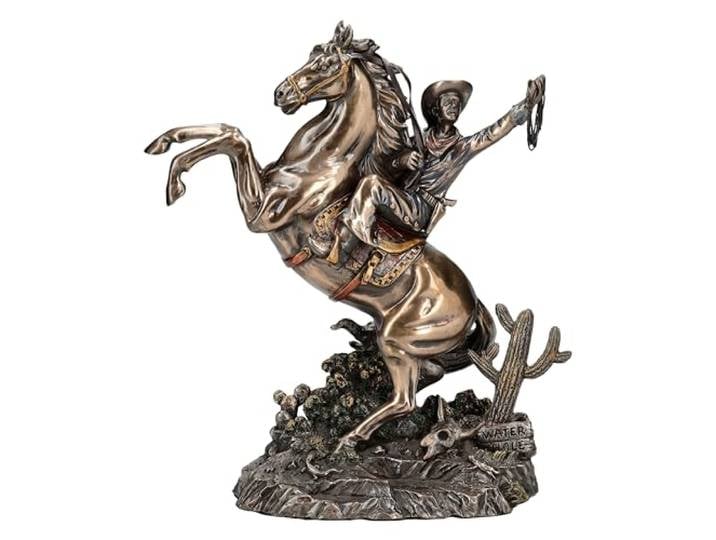
Pacific Giftware Cowboy-Figur auf steigendem Pferd mit Lasso 25,5 cm - Western Deko, Prärie-Landschaft mit Kaktus und Totenkopf<p>Die <strong>Pacific Giftware Cowboy-Figur</strong> ist ein beeindruckendes Deko-Element, das die Faszination des Wilden Westens in dein Zuhause bringt. Mit einer Höhe von <strong>25,5 cm</strong>, einer Breite von <strong>23 cm</strong> und einer Tiefe von <strong>11 cm</strong> zeigt diese Figur einen Cowboy, der auf einem steigenden Pferd balanciert und sein Lasso hoch in den Himmel schwingt. Diese dynamische Darstellung ist eine Hommage an den klassischen Wildwest-Geist und zieht alle Blicke auf sich.</p><p>Die Figur ist aus hochwertigem Kunststein (Polyresin) gefertigt und sorgfältig bronziert sowie coloriert, was ihr eine ansprechende Optik verleiht. Die detailreiche Szenerie ist in eine typische Prärie-Landschaft eingebettet, die mit einem Kaktus, einem Schild mit der Aufschrift Water Hole , einem Rinder-Totenkopf und Eidechsen ausgestattet ist. Diese Elemente fangen das Wildwest-Flair perfekt ein und machen die Figur zu einem einzigartigen Kunstwerk.</p><p>Die <strong>Cowboy-Figur</strong> reflektiert die kulturelle Bedeutung und Romantik des amerikanischen Westens und ist ein absolutes Must-Have für Liebhaber der Cowboy-Kultur und der Wildwest-Geschichte. Mit ihrer lebhaften Pose und der dynamischen Umgebung wird sie zum Highlight jeder Sammlung und verleiht deinem Wohnraum einen Hauch von Abenteuer und Geschichte.</p>119,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Waves Dugan SpeechWaves Dugan Speech (ESD); Automix-Plugin; Automix-Anwendung für Waves SuperRack und eMotion LV1 Mixer, entwickelt in Zusammenarbeit mit Dan Dugan; mischt bis zu 64 Live-Mikrofonkanäle gleichzeitig automatisch und in Echtzeit; kein manuelles Regeln notwendig; sichert konstanten Gesamtpegel; perfekt abgestimmte Crossfades; nahtlose Integration in eMotion LV1 Mixer sowie SuperRack; unterstützte Formate: Waves SuperRack, eMotion LV1 Mixer599,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
MONACOR Speech-500/gr Das Speech-500 Ist Die Professionelle LösungDas SPEECH-500 ist die professionelle Lösung: für anspruchsvolle Sprach- und Musikübertragung und ist mit innovativer Technik ausgerüstet. Das Rednerpult kann mittels Elektroantrieb stufenlos in der Höhe eingestellt werden. Ein Notebook kann platzsparend unter der durchsichtigen Pultscheibe in einem speziell dafür vorgesehenen und zweistufig beleuchtbaren Fach untergebracht werden. Keine Wünsche offen lässt das eingebaute Audiosystem sowie die UHF-PLL-Funktechnik mit Sende- und Empfangsmodul. Diese ermöglicht im Audio-Link-Betrieb die kabellose Ansteuerung von weiteren Aktivlautsprechersystemen, die mit entsprechenden Funkempfängern ausgerüstet sind (z. B. TXA-800- und TXA-1000-Serie).Professionelles, elektrisch höhenverstellbares Rednerpult mit integriertem drahtlosem Audiosystem: Eingebauter 4-Kanal-Mischverstärker mit Limiter, 50 W, Elektrische stufenlose Höhenverstellung der Pulthöhe von 85-125 cm, Pult mit durchsichtiger Sicherheitsglasplatte und beleuchtetem Fach für ein Laptop, Eingebauter UHF-PLL-Empfänger (TXA-1822MR) mit 2 x 16 einstellbaren Frequenzen (863,1-864,9 MHz) mit Diversity-System, passende Sender wie TXA-800HSE oder TXA-800HT sind optional erhältlich, Eingebauter UHF-PLL-Sender (TXA-820MT) mit 16 einstellbaren Frequenzen (863,1-864,9 MHz) zum Aufbau von Audio-Funk-Übertragungsstrecken, 3 Eingänge über Kombi-Buchse Mic (XLR)/Line (6,3-mm-Klinke), Stereo-Line-Eingang (Cinch), Gainregler, 3-fach-Klangregelung für die Kombi-Eingänge, 2 schockabsorbierende XLR-Buchsen auf dem Pultaufsatz für 2 optionale Schwanenhalsmikrofone (belegen je einen Mikrofoneingang), passendes Mikrofon EMG-650P optional erhältlich, Zusätzliche XLR-Buchse für LED-Schwanenhalsleuchte (z. B. GNL-453XLR, optional erhältlich), 24-V-Phantomspeisung für Mic-Eingang 1 und 2, 1 Stereo-Line-Ausgang über Cinch-Buchsen, 2-Wege-Lautsprechersystem mit 30-cm-Tieftöner (12") und Hochtonhorn (1"), Hochwertiges Gehäuse in Holz-Lack-Kombination, Standarddekor: Grau, lackiert, Referentenschildhalterung mit Klemmschraube montierbar, 3 zusätzliche Ablagefächer für Dokumente und andere Utensilien, 2 Lenkrollen mit Feststellbremse und 2 starre Rollen, Anmelde- und gebührenfrei in der EU.Lieferung ohne Laptop.Auch in anderen Farben erhältlich:Neben dem Standarddekor „Grau, lackiert” können Sie aus weiteren 20 Design-Optionen Ihre individuelle Farbe oder das passende Wunschdekor auswählen:Ahorn, Apfel dunkel, Buche, Buche dunkel, italienische Eiche, Eiche rötlich, Eiche rustikal, Erle, Kirsche, Kirsche dunkel, Kirsche hell, Tabak-Akazie, Walnuss dunkel, Walnuss hell, Wenge, Zwetschge, Apricot, Taubenblau, Vanille, Grau (Standard) und Weiß.Lieferzeit und Aufpreis auf Anfrage.Technische Daten: Nennleistung (PRMS): 50 W, Ausgangsleistung, gesamt: 100 W, Frequenzbereich: 50-20000 Hz, Trägerfrequenz: 863,1-864,9 MHz, Reichweite: ≤ 30 m, Eingänge: 24 mV (Mic1-2, oben),4,5 mV (Mic1-3), 150 mV (Line1-3), 400 mV (Line) , Klangregler, Tiefen: ±12 dB/60 Hz, Klangregler, Mitten: ±7 dB/1 kHz,...3211,00 €*Versand: 99,00 €Sichere Weiterleitung zum Anbieter
-
Aspects of Western Subanon Formal Speech, Sachbücher von William C HallDas Buch "Aspects of Western Subanon Formal Speech" bietet eine umfassende Analyse des Sprachverhaltens der Western Subanon-Gemeinschaft in formellen Kontexten, wie Zeremonien und Rechtsstreitigkeiten. Es beleuchtet die Unterschiede zwischen der Untersuchung von Sprache als eigenständigem Element und der Analyse von Sprache innerhalb kultureller Kontexte. Das Werk geht davon aus, dass die linguistische Struktur, die soziale Struktur und das sprachliche Verhalten in sozialen Kontexten systematisch und strukturiert sind. Zudem werden die Dynamiken des Austauschs in formellen Situationen sowie poetische Muster behandelt. Das Buch enthält fünf Texte mit Glossar und freier Übersetzung, die den Leser*innen einen tiefen Einblick in die sprachlichen Praktiken dieser Gemeinschaft ermöglichen.35,80 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Wie benutze ich Text to Speech?
Um Text-to-Speech zu verwenden, benötigen Sie zunächst eine Software oder eine App, die diese Funktion unterstützt. Öffnen Sie dann die gewünschte Textdatei oder geben Sie den Text ein, den Sie vorgelesen haben möchten. Wählen Sie die gewünschte Stimme und Sprache aus, und starten Sie die Wiedergabe. Sie können auch die Geschwindigkeit und Lautstärke der Sprachausgabe anpassen. Text-to-Speech ist eine nützliche Funktion für Menschen mit Sehbehinderungen oder für diejenigen, die sich Texte lieber vorlesen lassen möchten. **
-
Kennt jemand ein gutes Text-to-Speech-Programm?
Ja, es gibt verschiedene gute Text-to-Speech-Programme auf dem Markt. Einige beliebte Optionen sind Google Text-to-Speech, Amazon Polly und Microsoft Azure Text-to-Speech. Diese Programme bieten eine natürliche Sprachausgabe und können in verschiedenen Anwendungen wie Sprachassistenten, Vorleseprogrammen oder Barrierefreiheitstools verwendet werden. **
-
Was ist die beste KI für Text-to-Speech?
Es gibt viele gute KI-Modelle für Text-to-Speech, aber einige der bekanntesten und am weitesten entwickelten sind Tacotron 2, WaveNet und Deep Voice. Diese Modelle haben eine hohe Qualität und Natürlichkeit in der Generierung von Sprache und werden von vielen Unternehmen und Entwicklern verwendet. Es ist jedoch wichtig zu beachten, dass die "beste" KI für Text-to-Speech von den spezifischen Anforderungen und Präferenzen abhängt, da verschiedene Modelle unterschiedliche Stärken und Schwächen haben können. **
-
Gibt es ein Open-Source-Text-to-Speech-Modell?
Ja, es gibt mehrere Open-Source-Text-to-Speech-Modelle. Ein bekanntes Beispiel ist das Tacotron-Modell, das von Google entwickelt wurde. Es ermöglicht die Generierung von natürlicher Sprache aus Text und ist in der Open-Source-Community weit verbreitet. Es gibt auch andere Modelle wie WaveNet und DeepVoice, die ebenfalls Open-Source sind. **

Wie funktioniert die Text-to-Speech-Funktion auf TikTok?
Die Text-to-Speech-Funktion auf TikTok verwendet eine Spracherkennungssoftware, um den eingegebenen Text in Sprache umzuwandeln. Die Software analysiert den Text und generiert dann eine Sprachausgabe, die im Video abgespielt wird. Die Benutzer können aus verschiedenen Sprachoptionen wählen und die Geschwindigkeit der Sprachausgabe anpassen. **
Wie lautet der deutsche Text-to-Speech-Stimme VBS?
Die deutsche Text-to-Speech-Stimme VBS steht für "Voices for Blind and Sight-impaired" und ist eine speziell entwickelte Stimme für blinde und sehbehinderte Menschen. Sie ermöglicht es ihnen, geschriebenen Text in gesprochene Sprache umzuwandeln und so Informationen zu erhalten. **
Top-Angebote
Produkte zum Begriff Text-to-Speech TTS:
-
Pacific Giftware Cowboy-Figur auf steigendem Pferd mit Lasso 25,5 cm - Western Deko, Prärie-Landschaft mit Kaktus und Totenkopf<p>Die <strong>Pacific Giftware Cowboy-Figur</strong> ist ein beeindruckendes Deko-Element, das die Faszination des Wilden Westens in dein Zuhause bringt. Mit einer Höhe von <strong>25,5 cm</strong>, einer Breite von <strong>23 cm</strong> und einer Tiefe von <strong>11 cm</strong> zeigt diese Figur einen Cowboy, der auf einem steigenden Pferd balanciert und sein Lasso hoch in den Himmel schwingt. Diese dynamische Darstellung ist eine Hommage an den klassischen Wildwest-Geist und zieht alle Blicke auf sich.</p><p>Die Figur ist aus hochwertigem Kunststein (Polyresin) gefertigt und sorgfältig bronziert sowie coloriert, was ihr eine ansprechende Optik verleiht. Die detailreiche Szenerie ist in eine typische Prärie-Landschaft eingebettet, die mit einem Kaktus, einem Schild mit der Aufschrift Water Hole , einem Rinder-Totenkopf und Eidechsen ausgestattet ist. Diese Elemente fangen das Wildwest-Flair perfekt ein und machen die Figur zu einem einzigartigen Kunstwerk.</p><p>Die <strong>Cowboy-Figur</strong> reflektiert die kulturelle Bedeutung und Romantik des amerikanischen Westens und ist ein absolutes Must-Have für Liebhaber der Cowboy-Kultur und der Wildwest-Geschichte. Mit ihrer lebhaften Pose und der dynamischen Umgebung wird sie zum Highlight jeder Sammlung und verleiht deinem Wohnraum einen Hauch von Abenteuer und Geschichte.</p>119,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Waves Dugan SpeechWaves Dugan Speech (ESD); Automix-Plugin; Automix-Anwendung für Waves SuperRack und eMotion LV1 Mixer, entwickelt in Zusammenarbeit mit Dan Dugan; mischt bis zu 64 Live-Mikrofonkanäle gleichzeitig automatisch und in Echtzeit; kein manuelles Regeln notwendig; sichert konstanten Gesamtpegel; perfekt abgestimmte Crossfades; nahtlose Integration in eMotion LV1 Mixer sowie SuperRack; unterstützte Formate: Waves SuperRack, eMotion LV1 Mixer599,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Kennt ihr ein gutes Open-Source-Text-to-Speech (TTS)-Modell?
Ja, ein bekanntes Open-Source-Text-to-Speech-Modell ist Tacotron. Es wurde von Google entwickelt und ist in der Lage, natürliche Sprache zu generieren. Tacotron ist in Python implementiert und kann für verschiedene Anwendungen verwendet werden, wie z.B. Sprachassistenten oder Hörbücher. **
-
Wie funktioniert Speech to Text?
Speech to Text funktioniert, indem gesprochene Wörter mithilfe von Spracherkennungssoftware in Text umgewandelt werden. Dabei werden die Audiosignale des gesprochenen Textes analysiert und in Text umgewandelt. Die Software erkennt dabei Sprachmuster, Wörter und Sätze, um sie korrekt zu transkribieren. Dieser Prozess basiert auf komplexen Algorithmen und künstlicher Intelligenz, die kontinuierlich verbessert werden, um die Genauigkeit der Umwandlung zu erhöhen. Das Ergebnis ist ein geschriebener Text, der die gesprochene Sprache möglichst genau wiedergibt. **
-
Wie benutze ich Text to Speech?
Um Text-to-Speech zu verwenden, benötigen Sie zunächst eine Software oder eine App, die diese Funktion unterstützt. Öffnen Sie dann die gewünschte Textdatei oder geben Sie den Text ein, den Sie vorgelesen haben möchten. Wählen Sie die gewünschte Stimme und Sprache aus, und starten Sie die Wiedergabe. Sie können auch die Geschwindigkeit und Lautstärke der Sprachausgabe anpassen. Text-to-Speech ist eine nützliche Funktion für Menschen mit Sehbehinderungen oder für diejenigen, die sich Texte lieber vorlesen lassen möchten. **
-
Kennt jemand ein gutes Text-to-Speech-Programm?
Ja, es gibt verschiedene gute Text-to-Speech-Programme auf dem Markt. Einige beliebte Optionen sind Google Text-to-Speech, Amazon Polly und Microsoft Azure Text-to-Speech. Diese Programme bieten eine natürliche Sprachausgabe und können in verschiedenen Anwendungen wie Sprachassistenten, Vorleseprogrammen oder Barrierefreiheitstools verwendet werden. **
Ähnliche Suchbegriffe für Text-to-Speech TTS
-
MONACOR Speech-500/gr Das Speech-500 Ist Die Professionelle LösungDas SPEECH-500 ist die professionelle Lösung: für anspruchsvolle Sprach- und Musikübertragung und ist mit innovativer Technik ausgerüstet. Das Rednerpult kann mittels Elektroantrieb stufenlos in der Höhe eingestellt werden. Ein Notebook kann platzsparend unter der durchsichtigen Pultscheibe in einem speziell dafür vorgesehenen und zweistufig beleuchtbaren Fach untergebracht werden. Keine Wünsche offen lässt das eingebaute Audiosystem sowie die UHF-PLL-Funktechnik mit Sende- und Empfangsmodul. Diese ermöglicht im Audio-Link-Betrieb die kabellose Ansteuerung von weiteren Aktivlautsprechersystemen, die mit entsprechenden Funkempfängern ausgerüstet sind (z. B. TXA-800- und TXA-1000-Serie).Professionelles, elektrisch höhenverstellbares Rednerpult mit integriertem drahtlosem Audiosystem: Eingebauter 4-Kanal-Mischverstärker mit Limiter, 50 W, Elektrische stufenlose Höhenverstellung der Pulthöhe von 85-125 cm, Pult mit durchsichtiger Sicherheitsglasplatte und beleuchtetem Fach für ein Laptop, Eingebauter UHF-PLL-Empfänger (TXA-1822MR) mit 2 x 16 einstellbaren Frequenzen (863,1-864,9 MHz) mit Diversity-System, passende Sender wie TXA-800HSE oder TXA-800HT sind optional erhältlich, Eingebauter UHF-PLL-Sender (TXA-820MT) mit 16 einstellbaren Frequenzen (863,1-864,9 MHz) zum Aufbau von Audio-Funk-Übertragungsstrecken, 3 Eingänge über Kombi-Buchse Mic (XLR)/Line (6,3-mm-Klinke), Stereo-Line-Eingang (Cinch), Gainregler, 3-fach-Klangregelung für die Kombi-Eingänge, 2 schockabsorbierende XLR-Buchsen auf dem Pultaufsatz für 2 optionale Schwanenhalsmikrofone (belegen je einen Mikrofoneingang), passendes Mikrofon EMG-650P optional erhältlich, Zusätzliche XLR-Buchse für LED-Schwanenhalsleuchte (z. B. GNL-453XLR, optional erhältlich), 24-V-Phantomspeisung für Mic-Eingang 1 und 2, 1 Stereo-Line-Ausgang über Cinch-Buchsen, 2-Wege-Lautsprechersystem mit 30-cm-Tieftöner (12") und Hochtonhorn (1"), Hochwertiges Gehäuse in Holz-Lack-Kombination, Standarddekor: Grau, lackiert, Referentenschildhalterung mit Klemmschraube montierbar, 3 zusätzliche Ablagefächer für Dokumente und andere Utensilien, 2 Lenkrollen mit Feststellbremse und 2 starre Rollen, Anmelde- und gebührenfrei in der EU.Lieferung ohne Laptop.Auch in anderen Farben erhältlich:Neben dem Standarddekor „Grau, lackiert” können Sie aus weiteren 20 Design-Optionen Ihre individuelle Farbe oder das passende Wunschdekor auswählen:Ahorn, Apfel dunkel, Buche, Buche dunkel, italienische Eiche, Eiche rötlich, Eiche rustikal, Erle, Kirsche, Kirsche dunkel, Kirsche hell, Tabak-Akazie, Walnuss dunkel, Walnuss hell, Wenge, Zwetschge, Apricot, Taubenblau, Vanille, Grau (Standard) und Weiß.Lieferzeit und Aufpreis auf Anfrage.Technische Daten: Nennleistung (PRMS): 50 W, Ausgangsleistung, gesamt: 100 W, Frequenzbereich: 50-20000 Hz, Trägerfrequenz: 863,1-864,9 MHz, Reichweite: ≤ 30 m, Eingänge: 24 mV (Mic1-2, oben),4,5 mV (Mic1-3), 150 mV (Line1-3), 400 mV (Line) , Klangregler, Tiefen: ±12 dB/60 Hz, Klangregler, Mitten: ±7 dB/1 kHz,...3211,00 €*Versand: 99,00 €Sichere Weiterleitung zum Anbieter
-
Aspects of Western Subanon Formal Speech, Sachbücher von William C HallDas Buch "Aspects of Western Subanon Formal Speech" bietet eine umfassende Analyse des Sprachverhaltens der Western Subanon-Gemeinschaft in formellen Kontexten, wie Zeremonien und Rechtsstreitigkeiten. Es beleuchtet die Unterschiede zwischen der Untersuchung von Sprache als eigenständigem Element und der Analyse von Sprache innerhalb kultureller Kontexte. Das Werk geht davon aus, dass die linguistische Struktur, die soziale Struktur und das sprachliche Verhalten in sozialen Kontexten systematisch und strukturiert sind. Zudem werden die Dynamiken des Austauschs in formellen Situationen sowie poetische Muster behandelt. Das Buch enthält fünf Texte mit Glossar und freier Übersetzung, die den Leser*innen einen tiefen Einblick in die sprachlichen Praktiken dieser Gemeinschaft ermöglichen.35,80 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
the t.bone Speech 100 Bthe t.bone Speech 100 B - Netzteilerweiterung (Booster) für die Sprechstellen 100 C und 100 D des digitalen Konferenzsystem Speech 100, ein 100 B versorgt bis zu 32 zusätzliche Sprechstellen (1x 100 M +1x 100 B = 2x16 + 2x16 =64); mit einem zweiten sind bis zu 72 Mikrofonstationen (max.) möglich (1x 100 M +1x 100 B +1x 100 B = 2x12 + 2x12 +2x12 =72); Leistungsaufnahme 72W; Abmessungen; 305x197x45mm; Gewicht: 2,45kg169,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was ist die beste KI für Text-to-Speech?
Es gibt viele gute KI-Modelle für Text-to-Speech, aber einige der bekanntesten und am weitesten entwickelten sind Tacotron 2, WaveNet und Deep Voice. Diese Modelle haben eine hohe Qualität und Natürlichkeit in der Generierung von Sprache und werden von vielen Unternehmen und Entwicklern verwendet. Es ist jedoch wichtig zu beachten, dass die "beste" KI für Text-to-Speech von den spezifischen Anforderungen und Präferenzen abhängt, da verschiedene Modelle unterschiedliche Stärken und Schwächen haben können. **
-
Gibt es ein Open-Source-Text-to-Speech-Modell?
Ja, es gibt mehrere Open-Source-Text-to-Speech-Modelle. Ein bekanntes Beispiel ist das Tacotron-Modell, das von Google entwickelt wurde. Es ermöglicht die Generierung von natürlicher Sprache aus Text und ist in der Open-Source-Community weit verbreitet. Es gibt auch andere Modelle wie WaveNet und DeepVoice, die ebenfalls Open-Source sind. **
-
Wie funktioniert die Text-to-Speech-Funktion auf TikTok?
Die Text-to-Speech-Funktion auf TikTok verwendet eine Spracherkennungssoftware, um den eingegebenen Text in Sprache umzuwandeln. Die Software analysiert den Text und generiert dann eine Sprachausgabe, die im Video abgespielt wird. Die Benutzer können aus verschiedenen Sprachoptionen wählen und die Geschwindigkeit der Sprachausgabe anpassen. **
-
Wie lautet der deutsche Text-to-Speech-Stimme VBS?
Die deutsche Text-to-Speech-Stimme VBS steht für "Voices for Blind and Sight-impaired" und ist eine speziell entwickelte Stimme für blinde und sehbehinderte Menschen. Sie ermöglicht es ihnen, geschriebenen Text in gesprochene Sprache umzuwandeln und so Informationen zu erhalten. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.